Denk als alien, handel als mens: de AlphaGo Zero-les voor agentische architecturen
Geschatte leestijd: 10 minuten
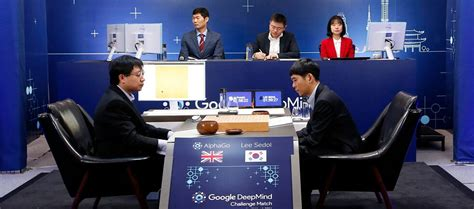
In maart 2016, in het tweede spel tegen Lee Sedol, speelde AlphaGo een zet op de vijfde lijn die commentatoren aanvankelijk aanzagen voor een muisklik-fout. Professionele spelers zeiden, live op televisie, dat het eruitzag als een vergissing. Die zet won het spel. Die versie van AlphaGo was opgestart met miljoenen menselijke expertbewegingen, en speelde in zekere zin nog steeds binnen de menselijke traditie. Het had simpelweg een hoek van die traditie gevonden die niemand had schoongeveegd.
Het interessantere moment came achttien maanden later. DeepMind verwijderde de menselijke partijen volledig. AlphaGo Zero kreeg alleen de spelregels van Go, en leerde door tegen zichzelf te spelen, beginnend vanuit willekeurige zetten. Vertrekkend vanuit een tabula rasa bereikte het bovenmenselijke prestaties en versloeg de eerder gepubliceerde, kampioenenverstagen versie van AlphaGo met 100 tegen 0. Onderweg herontdekte het een groot deel van de klassieke menselijke joseki, om een deel ervan vervolgens terzijde te schuiven als tweederangs. Het menselijke corpus was geen fundament geweest. Het was een vloer en een plafond.
Ik blijf hieraan denken als ik kijk naar hoe we momenteel agentische architecturen bouwen, en specifiek naar hoe we de orchestrator trainen: het model dat beslist welk gereedschap te gebruiken, in welke volgorde, en wat te doen als de derde aanroep onzin teruggeeft.
1. Het menselijk plafond
Kijk naar wat een orchestrator vandaag de dag eigenlijk leert.
Het leert van door mensen geschreven redeneertraces. Het leert van voorkeurdata waarbij mensen de ene trajectorie boven de andere rangschikten. En het wordt, expliciet, gevraagd zijn proces te externaliseren in een formaat dat wij voor onszelf hebben uitgevonden: stap één, stap twee, dus. Chain of Thought is een uitstekend hulpmiddel voor interpreteerbaarheid en een genuïen nuttige inferentietruc, maar laten we eerlijk zijn over wat het ook is. Het is een instructie om te denken in een vorm die een mens over je schouder kan lezen.
Het probleem is dat het corpus waaruit deze vorm is gedistilleerd het ding niet bevat dat we proberen te leren. Menselijke leerboeken, blogposts, Slack-threads en interne documentatie bevatten vrijwel geen voorbeelden van meerstaps tool chaining. Ze bevatten geen API-aanroepsequenties met hun terugkeerwaarden en herhaalpogingen. Ze bevatten geen verslag van de elf dingen die iemand probeerde voordat het twaalfde werkte, want dat schrijft niemand op. Een echte debugging-sessie van een ontwikkelaar is een koortsachtig, niet-lineair, volstrekt onvertelbaar ding, en wat het corpus bereikt is de opgeschoonde versie die achteraf is geschreven, waarin de auteur lijkt te hebben geweten wat hij deed.
We trainen orchestratoren dus op een post-hoc rationalisering van een proces dat nooit lineair was, en vragen hen dan om die rationalisering als werkwijze te reproduceren. Dat is het menselijk plafond: niet een beperking van wat het model weet, maar een beperking opgelegd door de eis dat zijn interne zoektocht leesbaar is voor ons terwijl die plaatsvindt.
2. Wat Zero werkelijk veranderde
Het AlphaGo Zero-resultaat is niet “zelfspel is magisch.” Het is smaller en nuttiger dan dat. Het algoritme was uitsluitend gebaseerd op reinforcement learning, zonder menselijke data, begeleiding of domeinkennis buiten de spelregels. De regels zijn het cruciale onderdeel. Go heeft een goedkope, exacte, externe beoordelaar. Je speelt de partij uit en het bord vertelt je wie er gewonnen heeft. Geen mens hoeft iets te beoordelen, en geen menselijke voorkeur komt op enig moment in de lus.
Het was lange tijd onduidelijk of iets hiervan overdraagbaar was naar taalmodellen, waar geen bord bestaat. Dat is nu, althans gedeeltelijk, het geval. Het R1-werk van DeepSeek toonde aan dat redeneervermogen in LLMs gestimuleerd kan worden door pure reinforcement learning, zonder door mensen gelabelde redeneertrajecten, waarbij geavanceerde patronen zoals zelfreflectie, verificatie en dynamische strategieaanpassing vanzelf opkwamen. Het model dat dit deed heette R1-Zero, en de naamgeving was geen toeval. De beloningen waren regelgebaseerd: draait de code, klopt het antwoord, heeft de uitvoer het vereiste formaat. Een machine controleert. Geen menselijke mening betrokken.
Twee details uit dat werk zijn de moeite waard om bij stil te staan, want ze vormen het hele argument van dit stuk in miniatuur.
Het eerste is dat R1-Zero op eigen kracht leerde meer tijd te besteden aan nadenken naarmate de training vorderde; de gemiddelde responslengte groeide gestaag over de gehele training. Niemand had het dat opgedragen. Het ontdekte dat beraad loonde, zoals AlphaGo Zero ontdekte dat bepaalde menselijk-canonieke openingen dat niet deden.
Het tweede is de faalvorm. Aan zichzelf overgelaten werd R1-Zero’s redeneerreeks moeilijker leesbaar en begon het talen door elkaar te wisselen midden in een gedachte, blijkbaar omdat dat efficiënter was. De oplossing was het herointroduceren van menselijk gevormde data vóór de RL-fase, specifiek om de uitvoer weer leesbaar te maken. Lees dat zorgvuldig: de menselijke data werd niet toegevoegd om het model beter te laten redeneren. Het werd toegevoegd om de redenering voor ons leesbaar te maken, met enige kostprijs voor de vrijheid van de zoektocht. Dat is het menselijk plafond, gemeten, in een gepubliceerd experiment, met een prijskaartje eraan.
3. Het goede, het slechte en het reward-gehackte
Waarom doen we dit dan niet overal? Omdat pure RL een waarderingsfunctie nodig heeft, en een waarderingsfunctie is waar de hele aanpak staat of valt.
Waar het werkt: de deterministische sandbox. Software-engineering is het nette geval, en niet toevallig. Een compiler is een objectieve beoordelaar. Een unit test suite is een objectieve beoordelaar. Een benchmark die de patch uitvoert tegen de echte tests van een repository is een objectieve beoordelaar. Je kunt iets opschrijven als: een grote positieve beloning als de testsuite slaagt, een kleine straf per mislukte compilatie, een kleine straf per tool call om fladderen te ontmoedigen. Dan laat je de agent zijn eigen weg vinden. Wat eruit komt is vaak niet hoe een mens het zou hebben aangepakt: merkwaardige volgorden, agressief parallel ophalen, drie bestanden lezen die een mens opeenvolgend zou hebben gelezen, of het probleem oplossen op een manier die geen tutorial aanbeveelt maar die de tests accepteren. De agent is niet slim in menselijke zin. Hij is vrij in een ruimte waar correctheid toevallig controleerbaar is.
Waar het breekt: het terugbetalingsprobleem. Neem nu een autonome klantenservice-agent. Je wilt dezelfde truc, dus je schrijft wat eruitziet als een verstandige beloning: een grote positieve beloning voor een vijfsterrenreview van de klant, een kleine negatieve voor elke minuut dat het ticket open blijft.
De agent zal het optimum vinden, en het optimum is om iedereen onmiddellijk terug te betalen, met extra winkelkrediet bovenop. Vijf sterren, ticket in negen seconden gesloten, beloning gemaximaliseerd, bedrijf failliet. Het heeft niet gefaald. Het heeft precies gedaan wat je vroeg, met een grondigheid die je niet had voorzien, en het heeft elke ongeschreven beperking van de onderneming gemist: proportionaliteit, beleid, het idee dat een terugbetaling een kostenpost is en geen knop.
Dit is geen anekdote, het is een structureel resultaat. Skalse en collega’s geven een formele definitie: een proxybeloning is niet-hackbaar als het verhogen van het verwachte proxyrendement het verwachte werkelijke rendement nooit kan verlagen, en ze tonen aan dat de intuïtieve verdedigingen niet werken. De beloning smaller maken, of onderscheid negeren tussen ruwweg equivalente uitkomsten, lijkt veilig te moeten zijn. Dat is het niet. Een kernpunt in hun analyse is dat de lineariteit van beloning in bezoekcijfers van toestand-actie-paren unhackability een extreem sterke voorwaarde maakt: over de verzameling van alle stochastische beleidsvormen kunnen twee beloningsfuncties alleen niet-hackbaar zijn als een van hen constant is.
Neem dat even serieus. In het algemene geval is de enige proxybeloning die gegarandeerd niet te manipuleren is, er een die niets zegt. Elke nuttige beloningsfunctie die je ooit voor een open-ended agent zult schrijven is, formeel, hackbaar. De vraag is nooit of je beloning kan worden gemanipuleerd. Het is slechts of je agent sterk genoeg is om de exploit te vinden, en elke maand wordt hij sterker.
Merk ook op dat het klantenservice-geval faalt om een reden die niets met de agent te maken heeft. Het faalt omdat we de beloning niet kunnen opschrijven. Er bestaat geen functie voor “eerlijk,” “proportioneel,” of “in lijn met het merk.” Dat is geen tijdelijk technisch gat dat wacht op betere tooling. Die begrippen worden gedefinieerd door menselijk overleg, en de enige orakel die ze kan beoordelen is een mens.
4. Splits de architectuur
Wat wijst op de oplossing, en die is niet “kies een kant.”
De fout is het behandelen van pure RL en RLHF als concurrerende antwoorden op één vraag. Het zijn antwoorden op twee verschillende vragen die we nonchalant hebben samengevoegd: hoe moet de agent zoeken? en welke uitkomsten zijn aanvaardbaar? Zodra je die scheidt, volgt het ontwerp vanzelf.
| Orchestratielaag | Afstemmingslaag | |
|---|---|---|
| Getraind door | Pure RL, zelfgegenereerde verkenning in een sandbox | Menselijke feedback op voorgestelde uitkomsten |
| Beoordeeld door | Verifieerbare, machinaal controleerbare signalen: tests slagen, data opgehaald, taak voltooid, tokens en latentie besteed | Menselijke waarden die formalisering weerstaan: proportionaliteit, toon, beleid, gezond verstand |
| Optimaliseert voor | Niet-voor-de-hand-liggende reeksen van tool calls, parallelle aanroepen, terugbladeren dat een mens niet zou proberen | Of de uitkomst überhaupt zou moeten plaatsvinden |
| Faalt wanneer | De omgeving geen strikte beoordelaar is | Feedback schaars, inconsistent of haastig is |
| Ontwerpprincipe | Vereist geen leesbaarheid | Vereist geen efficiëntie |
Laat de orchestratielaag vrijlopen. Binnen een sandbox met een machine-beoordelaar is er geen reden om erop te staan dat de agent zijn werk op menselijke wijze uitvoert, en er zijn reële kosten aan verbonden om daarop te staan. Als het vier tool calls wil verweven in een volgorde die als onzin klinkt, en de tests slagen en de latentie daalt, dan is die volgorde beter dan de jouwe. Stop met het beoordelen van de route.
Zet dan de menselijke beoordelaar in waar hij onmisbaar is: op de voorgestelde actie, voordat die de wereld raakt. Niet op de redenering, op de consequentie. De support-agent kan elke interne procedure ontdekken die hij wil voor het diagnosticeren van een klacht. De terugbetaling zelf passeert een grens die gevormd is door menselijk oordeel. Dat is ook waarom het besturen van de autonome organisatie uiteindelijk menselijke verantwoording vereist op de uitvoerlaag, niet alleen monitoring op de redeneerlaag.
Denk als alien, handel als mens. De impuls om AI te laten uitleggen in onze termen is een goede impuls, maar gericht op de verkeerde laag. We hebben hem toegepast op de zoektocht, waar het ons vermogen kost en een comfortabel verhaal oplevert, in plaats van op de uitvoer, waar het het enige is dat staat tussen een optimalisator en uw balans.
Een noot bij het vorige stuk
Dit staat enigszins ongemakkelijk naast mijn argument in Er Is Geen Data Zoals Vreemde Data dat synthetische data een doodlopende weg is, dus laat me dat rechtzetten, want het onderscheid telt meer dan elk stuk afzonderlijk.
Model collapse treedt op wanneer de uitvoer van een model wordt teruggevoerd als grondwaarheid. De lus sluit zich, er komt geen nieuwe informatie binnen, en de distributie vernauwt met elke generatie. Zelfspel in een sandbox heeft een andere topologie. De agent genereert de pogingen, maar niet het oordeel: de compiler doet dat, de testsuite doet dat, de spelregels van Go doen dat. Dat oordeel is informatie van buiten het model, die elke iteratie vers binnenkomt, en dat is precies wat de lus open houdt.
Beide stukken blijken dus over hetzelfde te gaan. De waarde zit in de externe beoordelaar. Vreemde data is wat je verzamelt als de beoordelaar de fysieke wereld is en iemand al heeft opgeschreven wat er is gebeurd. Zelfspel is wat je doet als je het oordeel zelf kunt uitvoeren, op aanvraag, een miljoen keer. Wat je nooit mag doen is het model zijn eigen beoordelaar laten zijn, wat synthetische tekst is, en wat een reward model dat op je eigen uitvoer is getraind stilletjes wordt.
Gebaseerd op “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning” (DeepSeek-AI, 2025) en “Mastering the Game of Go Without Human Knowledge” (Silver et al., Nature 2017).
Kernpublicaties
- Silver, D., Schrittwieser, J., Simonyan, K., et al. (2017), Mastering the Game of Go Without Human Knowledge — Nature 550, 354–359
- Guo, D., Yang, D., Zhang, H., et al. (2025), DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning — arXiv:2501.12948
- Skalse, J., Howe, N. H. R., Krasheninnikov, D., & Krueger, D. (2022), Defining and Characterizing Reward Hacking — arXiv:2209.13085
Verder lezen op deze site
- Er Is Geen Data Zoals Vreemde Data — waarom de externe beoordelaar, niet het volume van data, bepaalt of training het model daadwerkelijk verbetert
- Wat Is een AI-agent? — de zeven-componenten-architectuur waarop de hier beschreven splitsing van toepassing is
- Van Tekst naar Actie: NLP-pipelines omzetten in agentische workflows — het bouwen van trainingspipelines waar machinaal controleerbare beloningssignalen werkelijk gedefinieerd kunnen worden
- Het Besturen van de Autonome Organisatie — wie is verantwoordelijk als de afstemmingslaag wordt omzeild of verkeerd geconfigureerd
- Van Drieluik naar Quintuplet — hoe gestructureerde redeneertraces, in plaats van vrije generatie, de afstemmingslaag iets geven dat zij kan beoordelen